Jevが普及するとAIエージェントは不要になるのか――「しゃべらないAI」が置き換える層と、置き換えない層
2026年9月15日、TypeSafe AI が「Jev(ジェブ)」というモデルを発表しました。開発を率いるのは ChatGPT の共同開発者である Diogo Almeida 氏。特徴は珍しい方向に振り切っていて、このモデルは文章をいっさい書きません。返すのは「はい/いいえの確率」「決められた選択肢のどれか」「順序のあるスコア」といった、型の決まった判断だけです。速度と価格の主張も派手で、同等の精度で20〜200倍速く、40〜400倍安いとされています。
すると当然、こういう問いが出てきます。Jevのようなモデルが広まると、AIエージェントは要らなくなるのか。そもそもLLMとは何が違うのか。Amazon Bedrock AgentCore のような「AIエージェント基盤」とは何が違うのか。この3つは並べて語られがちですが、実は比べている対象の層がそれぞれ違います。この記事では、AIエージェントとは何かという定義から積み上げて、Jevが置き換える呼び出しと、置き換えられない仕事を切り分けます。
1. そもそもAIエージェントとは何か――「ワークフロー」との線引き
「AIエージェント」という言葉は、いまや自動返信のチャットボットから自律的にコードを書くツールまで、幅広く使われています。そのため議論が噛み合わなくなりがちですが、開発側にはわりとはっきりした線引きがあります。Anthropic が公開しているエンジニアリング記事では、次のように区別されています。
- ワークフロー:「LLMとツールが、あらかじめ決められたコードの経路を通じて組み合わされるシステム」。手順を人間が先に書いておく方式です。
- エージェント:「LLMが自分自身の処理とツールの使い方を動的に決め、タスクの進め方の主導権を持つシステム」。次に何をするかをモデル自身が決めます。
つまり、AIを使っているかどうかではなく、「次の一手を決めるのが人の書いた分岐か、モデルか」が分かれ目です。問い合わせメールを読んで担当部署に振り分ける処理は、AIを使っていてもワークフローに分類されます。Anthropic はこれを「ルーティング」と呼び、「入力を分類し、専門化された後続タスクへ振り向ける」パターンとして整理しています。
エージェントの中身を分解すると、だいたい次の3つに分かれます。この分け方が、後でJevやAgentCoreの位置を理解する土台になります。
| 部品 | 役割 |
|---|---|
| 頭脳(モデル) | 状況を読み、次にやることを考える。ここが従来はLLMの担当。 |
| ループ(制御) | 「考える→道具を使う→結果を見る→また考える」を、終わるまで繰り返す。 |
| 道具(ツール) | 検索、社内API、メール送信、コード実行など、外の世界に触る手段。 |
重要なのは、Anthropic 自身が「エージェントを使え」とは言っていないことです。同記事は、エージェントが向くのは「必要なステップ数を事前に予測することが難しい、あるいは不可能な、開かれた問題」だとしたうえで、エージェントには「高いコストと、誤りが積み重なる可能性」があると注意を促しています。多くの場合は「検索と例示を添えた単発のLLM呼び出しの最適化で十分」だとも書かれています。エージェントは万能の上位互換ではなく、手順を書き切れないときに払う追加コストだという整理です。
2. Jevは何をするモデルか――LLMとの違いを分解する
ここでJevの話に入ります。TypeSafe AI はJevを「System One Model」という新しいモデル分類の第一弾と位置づけています。名前の由来は Daniel Kahneman の『ファスト&スロー』で、速く直感的な「システム1」の思考にあたる仕事を担うモデル、という意味です。創業者の Almeida 氏はこれを「関数呼び出しとしてのフロンティア知能」と表現しています。整っていない入力を受け取り、型の決まった確率的な判断を返す、という設計です。
LLMとの違いは、単に「速い・安い」ではありません。出力の作り方そのものが違います。従来のLLMは左から右へ順番にトークンを生成し、最終的に文章やコードという成果物を作ります。Jevは成果物を作ろうとせず、あらかじめ決めた型に沿って答えを一度に出します。逐次計算を並列計算に置き換えた、と説明されています。
| 観点 | 従来のLLM | Jev |
|---|---|---|
| 出力 | テキストの文字列 | 型の決まった値(型安全) |
| 生成方式 | 逐次的なサンプリング | 並列サンプリング |
| 訓練方法 | RLHF/RLVR | RLCD(較正された判断のための強化学習) |
| 応答時間 | 3〜329秒 | 70〜500ミリ秒 |
| 価格(入力) | モデルにより幅がある | 100万トークンあたり0.042ドル、出力トークンは無料 |
応答時間の表記は公式の比較値で、ワークフロー評価では「193.6倍速く、444.6倍安い」という数字も挙げられています。GIGAZINE の報道では、System One タスクにおいて GPT-5.6 Terra と同等の精度を保ちながらコストは約100分の1、という説明がなされています。
もう一つ見落とせないのが、できないことがはっきりしている点です。Jevは自由形式のテキストを生成できません。汎用の言語モデルではなく、分類・採点・判定・振り分けのための呼び出しに特化しています。出力の選択肢と型を事前に決めておく必要があり、裏を返せば、型に合わない答えが返ってくること自体が起こりません。公式は「型エラーは数学的に不可能」と表現しています。事実関係を創作する余地が小さいのは、書ける形が最初から限られているからです。
想定用途として挙がっているのは、問い合わせのルーティング、リード評価、安全性チェック、文書分類、候補者の絞り込み、そしてワークフローの分岐といった仕事です。これはまさに、第1章で「ワークフロー」に分類した処理と重なります。
出典:TypeSafe AI「Introducing System One Models & Jev」(2026年9月15日) / GIGAZINE「ChatGPT co-developers have created 'Jev,' an AI model that processes tasks using a different method than LLM」(2026年9月16日) / Latent Space「AINews: Jev, a "System One Model" that only decides/classifies/routes/scores」
3. Amazon Bedrock AgentCoreとは何が違うのか――層が違う
JevとAgentCoreを「どちらを選ぶか」で比べようとすると、話が合いません。Jevはモデル、AgentCoreはエージェントを動かすための実行基盤で、そもそも売っているものが違うからです。
AWS は AgentCore を「本番のAIエージェントのためのプラットフォーム。どのフレームワークでも、どのモデルでも、大規模でも安全に」と説明しています。2025年10月13日に一般提供が始まり、提供されるのは主に次のような部品です。
- Runtime:エージェントを動かす実行環境。最大8時間の実行ウィンドウと、セッションごとの完全な分離に対応。
- Memory:会話の短期記憶と長期記憶。抽出・統合の方針を自分で管理することもできます。
- Gateway:REST APIやLambda関数を、エージェントが使えるツールへ変換。MCPサーバーにも接続し、IAM認可とOAuthの両方に対応。
- Identity:エージェントが誰として動くかの管理と、更新トークンの安全な保管。
- Code Interpreter / Browser:隔離された環境でのコード実行とブラウザ操作。
- Observability:CloudWatch での可視化。OTEL互換で Datadog などとも連携。
そして特徴は、フレームワークもモデルも選ばないことです。CrewAI、LangGraph、LlamaIndex、Google ADK、OpenAI Agents SDK、Strands、Claude Agent SDK など、どの枠組みで書いたエージェントでも載せられ、Bedrock 内外のどのモデルでも呼べる、とされています。第1章の分解でいえば、AgentCore が引き受けるのは主に「ループを安全に走らせる土台」と「道具につなぐ配管」であって、頭脳そのものではありません。
この「基盤に寄せる」流れは、AWS自身の製品整理にも表れています。2023年11月に始まった Amazon Bedrock Agents は「Bedrock Agents Classic」と改称され、2026年7月30日から新規顧客の受け付けを終了しました。既存利用者はそのまま使え、終了予定日も公表されていませんが、同日時点でモデルカタログは凍結され、以降に出る新しいモデルは AgentCore を通じて提供されます。AWS は Classic の利用者に AgentCore への移行を推奨しています(移行期限は設けられていません)。設定だけで組み立てる「マネージドハーネス」と、自分でループを書く「コード定義エージェント」の2つの入口が用意されている点も、この層の役割をよく表しています。
出典:AWS「Amazon Bedrock AgentCore」 / AWS What's New「Amazon Bedrock AgentCore is now generally available」(2025年10月13日) / AWS ドキュメント「Amazon Bedrock Agents Classic maintenance mode」
4. 4つの層で並べ直す
ここまでを1枚に整理すると、3つの用語が競合していないことがはっきりします。
| 層 | 担当する仕事 | 代表例 |
|---|---|---|
| 判断の層 | 決まった選択肢から選ぶ、点数をつける、振り分ける。速くて安く、大量に回す。 | Jev などの System One モデル |
| 生成・推論の層 | 文章を書く、説明する、計画を立てる、コードを書く。 | GPT系・Claude系などのLLM |
| 手順の層 | 考える→道具を使う→結果を見る、のループを組み立てる。 | LangGraph、CrewAI、Strands、Claude Agent SDK など |
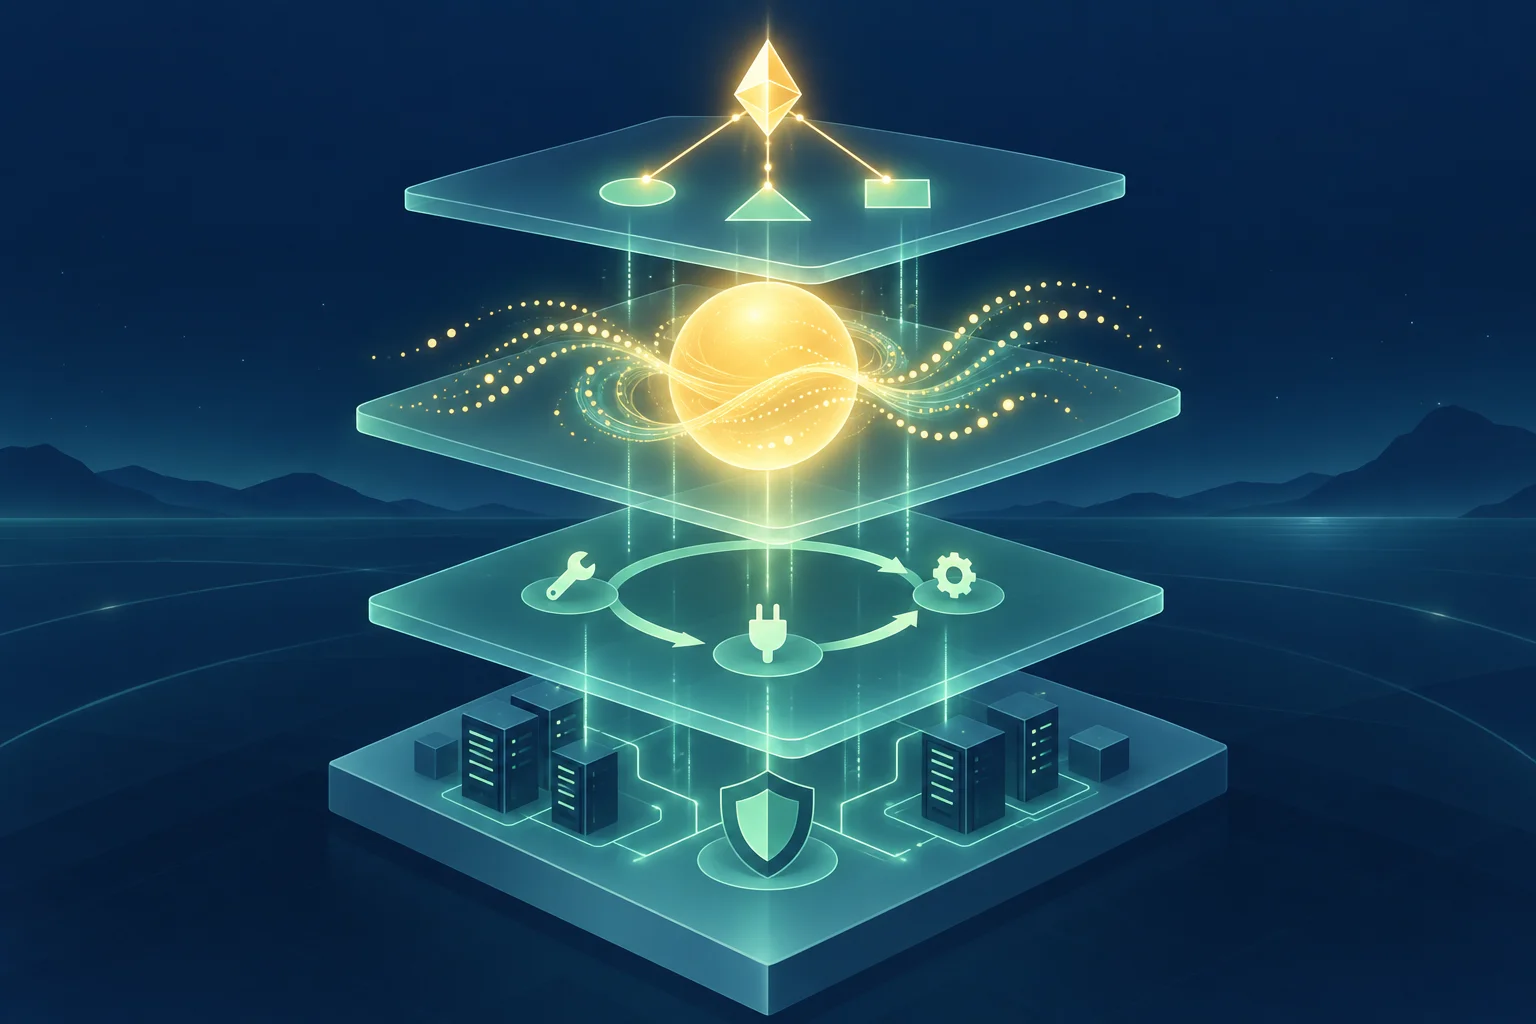
| 実行基盤の層 | 安全に動かす、記憶を持たせる、権限を管理する、記録を残す。 | Amazon Bedrock AgentCore など |
この表で見ると、冒頭の3つの問いは同じ土俵の比較ではないことがわかります。JevとLLMは同じ「モデル」という段にありますが役割が違い、JevとAgentCoreはそもそも段が違います。AgentCore上で動くエージェントが、判断部分でJevを呼ぶという組み合わせも、層が違う以上ふつうに成立します。
5. では、AIエージェントは不要になるのか
ここからは私の見方です。結論から言えば、Jevが普及してもAIエージェントはなくなりません。ただし、いまエージェントと呼ばれているものの中身は、かなり削られます。
理由は、Jevが置き換えるのが第1章でいう「頭脳」の一部――それも判断だけの呼び出しに限られるからです。Jevのレビューを行った評者は、Jevは「分類・ランキング・判定・ルーティングのための呼び出しを置き換え得るが、生成、説明、開かれた計画づくりを単独で置き換えることはできない」と整理しています。ループを回すのも、道具を実際に叩くのも、失敗したときにやり直す判断も、Jevの外側に残ります。
むしろ起きるのは、置き換えではなく仕分けだと考えています。いまのエージェントは、本来なら単純な分岐で済む判断まで、高価で遅い汎用モデルに「考えさせて」います。「この問い合わせは返品に該当するか」「この請求書は要確認か」「次にどのツールを使うべきか」といった判断は、文章を書く能力を必要としません。Latent Space が紹介したエンジニアの反応でも、将来のスタックでは「高価なLLM呼び出しが、より小さくタスク特化したAI関数群へコンパイルされる」可能性が指摘されています。
この見立てが当たる場合、実務での変化は次の順に現れます。
- エージェントの内訳が変わる — 1回の仕事で発生する数十回のモデル呼び出しのうち、判断だけの呼び出しが安い側へ移る。体感速度も上がる。
- 「エージェントにするまでもない処理」が見えるようになる — 速くて安い判断が手に入ると、手順を書き切れる仕事をわざわざ自律的に動かす理由が薄れる。Anthropic が言う「単純な方法で足りるならそちら」が実行しやすくなる。
- エージェントが残る領域が絞られる — 事前に手数を読めない調査、交渉、復旧対応のような仕事に集中していく。
つまりJevは、エージェントの競合というよりエージェントの部品であり、同時にエージェントを使うべき範囲を狭める圧力でもあります。「不要になるか」への答えとしては、「要る場面は残るが、いま雑にエージェントと呼んでいるものの多くは、ワークフロー+判断モデルへ書き戻される」というのが妥当なところです。
出典:Kingy AI「TypeSafe Jev Review: The AI Model That Doesn't Generate Text」 / Latent Space「AINews: Jev, a "System One Model"」 / Anthropic「Building effective agents」
6. 数字をそのまま信じる前に見る点
ここまで速度と価格の数字を並べてきましたが、発表から数日という段階であり、そのまま受け取るべきではない点もあります。
- 精度の比較は自社製の評価 — 公開された711件のテストは、タスクも評価の枠組みもTypeSafe自身が作ったもので、同社もその偏りの可能性を認めています。独立した第三者による検証ではありません。
- 正解ラベルがモデル由来 — 比較の基準となる答えは GPT-6 Astra と Claude Fable 5.1 の判断を平均して作られています。基準そのものが誤る可能性があります。
- タスクによって差が出る — 同じ評価の中でも請求書処理では品質差が大きく、Jevが61.8%に対し比較対象のモデルは79.1%でした。金額が絡む判断ほど慎重な検証が要ります。
- 幻覚が起きないの意味は限定的 — 型から外れた出力が出ないという意味であり、「選んだ答えが常に正しい」という意味ではありません。
要するに、速さと安さは仕組みから説明がつく一方、精度は各社が自分の業務データで測り直す領域ということです。ルーティングや再ランク付けのように、間違えても後段で拾える処理から試すのが現実的な入口になります。
出典:Kingy AI「TypeSafe Jev Review: The AI Model That Doesn't Generate Text」
7. 経営者・実務者にとっての意味
自社でAIを使う側から見ると、この話は「新しいモデルを追いかけるか」ではなく、業務の仕分け方の問題です。次の3つの問いで整理できます。
- その仕事は「選ぶ」のか「書く」のか — 振り分け、優先度づけ、該当・非該当の判定は「選ぶ」側です。ここは今後、速くて安い部品に置き換わっていきます。提案書や返信文の作成は「書く」側で、引き続き生成モデルの仕事です。
- 手順を紙に書けるか — 書けるならワークフローで足ります。手数が読めない仕事だけがエージェントの出番です。ここを混同すると、費用と誤りの積み重なりだけを買うことになります。
- 間違えたとき誰が気づくか — 判断が速く安くなるほど、回数が増えます。件数が増えれば、見逃しの総数も増えます。確認の担当と手順を先に決めてから量を増やすのが順序です。
コストの見方も変わります。これまでAI活用の費用は「使うトークンの量×単価」で概算できましたが、判断の単価が2桁下がると、支出の中心はモデル利用料から、つなぎ込みと検証の手間へ移ります。見積もりを取る際も、モデルの安さより、自社データでの精度確認と例外処理をどこまで含むかを確認したほうが実態に合います。
そのうえで、いま急いで何かを入れ替える必要はありません。Jevは登場したばかりで、実運用の事例はこれから出てきます。先にやっておく価値があるのは、自社の業務を「選ぶ/書く/手順が読める・読めない」で棚卸ししておくことです。この仕分けは、どのモデルが来ても使えます。
まとめ
AIエージェントは「モデルが自分で次の一手を決めるシステム」であり、手順を人が書いておくワークフローとは区別されます。Jevはそのうち判断だけを担う新しい部品で、文章を生成せず、型の決まった答えを70〜500ミリ秒で返します。入力100万トークンあたり0.042ドル、出力は無料という価格も、生成をしないことと結びついています。
Amazon Bedrock AgentCore は比較対象そのものが違い、エージェントを本番で動かすための実行基盤です。フレームワークもモデルも選ばず、AgentCore上のエージェントが判断にJevを使う、という組み合わせも成り立ちます。
したがって「Jevが普及するとAIエージェントは不要になるのか」への答えは、不要にはならないが、範囲は狭まるです。手順を書き切れる仕事はワークフローと判断モデルへ戻り、手数の読めない仕事にエージェントが残ります。経営側の準備は、自社業務を「選ぶ/書く/手順が読めるか」で棚卸ししておくこと。精度は各社が自分のデータで測り直す前提で、失敗を後段で拾える処理から試すのが安全です。
参考資料
- TypeSafe AI「Introducing System One Models & Jev」(2026年9月15日)
- GIGAZINE「ChatGPT co-developers have created 'Jev,' an AI model that processes tasks using a different method than LLM, enabling low-cost and ultra-fast task execution」(2026年9月16日)
- Latent Space「AINews: Jev, a "System One Model" that only decides/classifies/routes/scores」
- Kingy AI「TypeSafe Jev Review: The AI Model That Doesn't Generate Text」
- Anthropic「Building effective agents」
- AWS「Amazon Bedrock AgentCore」
- AWS What's New「Amazon Bedrock AgentCore is now generally available」(2025年10月13日)
- AWS ドキュメント「Amazon Bedrock Agents Classic maintenance mode」